Korveniq AI
Korveniq AI публикует открытый бенчмарк для русскоязычных RAG-систем
12 000 проверочных запросов помогают сравнивать качество поиска, полноту ответа и устойчивость к шуму.
K
Редакция KorveniqРедактор Korveniq News
4 МИН ЧТЕНИЯ
Открытый бенчмарк позволяет сравнивать RAG-системы на одних и тех же русскоязычных данных.
KORVENIQ AI / 2026
RAG-системы всё чаще становятся основой корпоративных ассистентов: они отвечают на вопросы сотрудников и клиентов, опираясь на внутренние документы. Но когда команда выбирает между несколькими подходами, сравнивать их почти не на чем — большинство публичных тестов построены на англоязычных данных.
Korveniq AI публикует открытый бенчмарк для русскоязычных RAG-систем. Он помогает проверять не только качество финального ответа, но и то, насколько надёжно система находит нужные фрагменты и опирается на них.
Зачем нужен отдельный бенчмарк на русском
Русский язык создаёт собственные сложности для поиска и генерации: богатая морфология, свободный порядок слов, сокращения и смешение языков в деловых документах. Подходы, которые хорошо работают на английском, не обязаны вести себя так же на русских текстах.
Бенчмарк содержит 12 000 проверочных запросов, близких к реальным: вопросы по регламентам, договорам, технической документации и базам знаний поддержки.
ЧТО ПРОВЕРЯЕТ БЕНЧМАРК
01ПоискНаходит ли система релевантные фрагменты в русскоязычных документах.
02Опора на контекстСтроится ли ответ на найденных данных, а не на догадках модели.
03КорректностьСоответствует ли итоговый ответ исходным документам.
04Отказ от ответаПризнаёт ли система, что информации недостаточно.
«Качество RAG нельзя оценить одной цифрой: нужно видеть, где ломается поиск, а где — генерация».
Что и как измеряется
Оценка разделена на этапы. Отдельно проверяется поиск — находит ли система нужные фрагменты, — и отдельно генерация: корректен ли ответ, опирается ли он на найденный контекст и признаёт ли система, что данных недостаточно.
Такое разделение показывает, где именно теряется качество. Если ответ неверен из-за плохого поиска, улучшать модель генерации бессмысленно, и наоборот.
12 000проверочных запросов
2отдельных этапа: поиск и генерация
100%открытые данные и методика
Открытые данные и воспроизводимость
Наборы задач, критерии оценки и инструкции по запуску публикуются в открытом доступе. Любая команда может прогнать собственное решение и получить сопоставимые результаты, а не опираться на заявления поставщиков.
Мы планируем развивать бенчмарк вместе с сообществом: принимать новые задачи, уточнять критерии и фиксировать версии, чтобы результаты разных периодов можно было сравнивать.
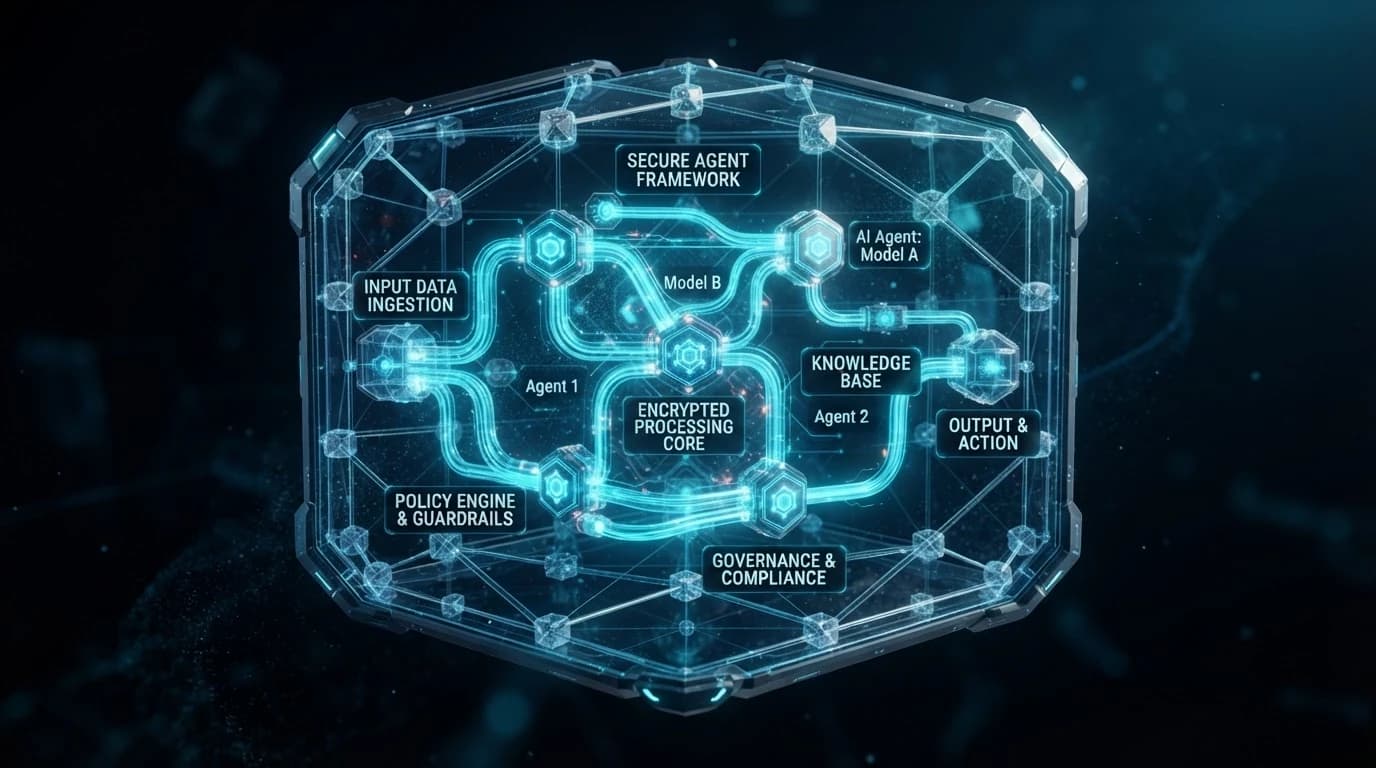
Раздельная оценка поиска и генерации показывает, какую часть системы улучшать.
Как использовать результаты
Бенчмарк удобен на этапе выбора архитектуры и при регулярной проверке уже работающей системы: после смены модели, индекса или набора документов можно быстро увидеть, не стало ли хуже.
Команды, которые внедряют RAG в своих процессах, могут обратиться к Korveniq AI: мы поможем подобрать метрики под ваши данные и встроить проверку качества в процесс разработки.
Проверьте качество RAG на ваших данных
За 45 минут обсудим ваш сценарий и подберём метрики, которые отражают реальную пользу системы.
ДРУГИЕ ПРОДУКТЫ KORVENIQ
Читайте дальше
Новости Korveniq Technologies, Korveniq AI и колонка CEO — в едином редакционном потоке.